
Nos últimos dois anos, a resposta padrão da indústria para qualquer automação inteligente tem sido acoplar um Large Language Model (LLM) autorregressivo em um prompt que termina com a clássica súplica: “responda estritamente em formato JSON válido”.
Essa abordagem impõe três gargalos severos em sistemas corporativos:
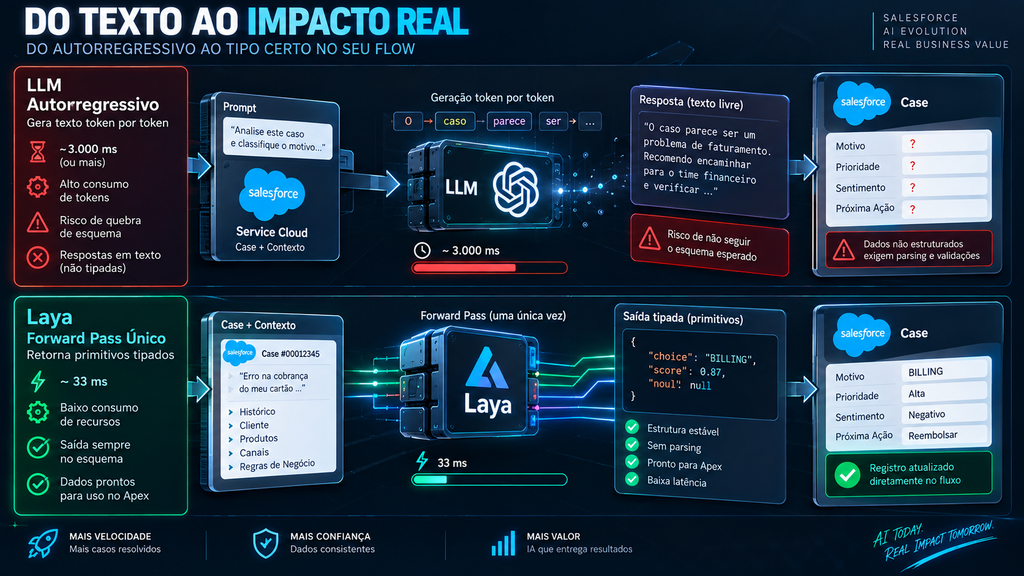
- Latência proibitiva: 800ms a 3.000ms para gerar uma única resposta.
- Fragilidade de parsing e alucinação: Modelos autorregressivos geram texto token por token; mesmo com structured outputs, o modelo pode inventar categorias ou quebrar esquemas.
- Pseudo-confiança: Quando um LLM diz
"confidence": 0.95, ele está apenas prevendo tokens que soam confiantes, sem calibração matemática real.
O projeto de código aberto Laya (desenvolvido por Nandakishor Mukkunnoth da Convai Innovations sob licença Apache 2.0, detalhado no anúncio sobre o Laya — 33ms Multilingual System 1 Decision Engine with Calibrated Probabilities) introduz uma mudança de paradigma: um motor de decisão System 1 que toma decisões tipadas com probabilidades matematicamente calibradas em ~33 ms, sem gerar nenhuma palavra de texto.
Abaixo, analisamos como o Laya funciona sob o capô e como arquitetar um padrão de design híbrido (System 1 + System 2) integrando o Laya ao ecossistema Salesforce (Service Cloud, Apex e Agentforce).
1. O que é o Laya e o Conceito de “System 1”
Inspirado na clássica divisão cognitiva de Daniel Kahneman (Thinking, Fast and Slow):
- System 1 (Rápido e Reflexivo): Julgamentos instantâneos e automáticos baseados em padrões estabelecidos (ex.: desviar de um obstáculo, categorizar um e-mail urgente).
- System 2 (Lento e Deliberativo): Raciocínio estruturado, planejamento em múltiplas etapas e resolução de problemas complexos (ex.: sintetizar uma ata, orquestrar ferramentas de negócios).
O Laya é projetado exclusivamente para o System 1. Seu lema é “Decisions, not text”. Ele recebe um estado (um e-mail, texto de ticket ou payload JSON) e uma lista de perguntas tipadas, retornando respostas estruturadas com pontuação de confiança probabilística em uma única passagem direta (forward pass).
                      [ Payload do Ticket / Caso ]
                                   │
                                   ▼
             ┌───────────────────────────────────────────┐
             │         Laya Router (<0.5ms Script Check) │
             └─────┬───────────────────────────────┬─────┘
                   │ (Texto em Inglês)             │ (100+ Idiomas)
                   ▼                               ▼
       ┌────────────────────────┐      ┌────────────────────────┐
       │   ModernBERT-large     │      │      mmBERT-base       │
       │     (421M params)      │      │     (322M params)      │
       └───────────┬────────────┘      └───────────┬────────────┘
                   └───────────────┬───────────────┘
                                   │ Single Forward Pass (~33ms)
                                   ▼
          ┌─────────────────────────────────────────────────┐
          │               3 Primitivas Tipadas              │
          │  1. Choice : Seleção categórica ponderada       │
          │  2. Score  : Escala ordinal (ex: urgência 0 a 2)│
          │  3. Noul   : Booleano calibrado P(true) [0.0..1]│
          └─────────────────────────────────────────────────┘
As Três Primitivas do Laya
Em vez de gerar texto aberto, o Laya opera com três primitivas nativas:
choice: Seleciona uma opção dentro de um catálogo definido em tempo de execução (ex.: roteamento de fila, intenção do cliente).score: Avalia o estado em uma escala ordinal fixa (ex.: urgência entre0e2, índice de severidade).noul: Um teste booleano que retorna $P(\text{true})$ estritamente calibrado entre0.0e1.0(ex.: risco de churn, tentativa de jailbreak, solicitação de reembolso).
Como Ele Elimina Alucinações e Garante Calibração
- Mecanismo de Máscaras (
[MASK]): O backbone do modelo (baseado em ModernBERT e mmBERT) é bidirecional. Cada opção da pergunta é emparelhada com um marcador[MASK]. O modelo extrai o estado oculto desse marcador para produzir um logit e aplica um softmax no espaço fechado de opções fornecidas na requisição. Como o modelo não emite tokens sequenciais, é matematicamente impossível alucinar valores fora do catálogo. - Treinamento RLCD (Reinforcement Learning for Calibrated Decisions): A otimização utiliza regras de pontuação estritamente próprias (proper scoring rules como perda logarítmica e esférica). Enquanto o RL tradicional incentiva o modelo a ser superconfiante para maximizar acurácia superficial, o RLCD pune o modelo caso a probabilidade declarada divirja da taxa empírica de acerto. O resultado é um Expected Calibration Error (ECE) de apenas 0.081 (contra 0.246 de alternativas de mercado como o TypeSafe Jev, conforme testes documentados no artigo de avaliação da eesel AI e na página do Laya no Hugging Face).
2. A Caveat Importante: Zero-Shot vs. Fine-Tuning
Como destacado por pesquisadores no HyperAI e nos fóruns do Hugging Face:
- Modelos base out-of-the-box: Apresentam acurácia próxima da aleatória (~36%) em classificações complexas e amplas sem especialização prévia.
- Checkpoint especializado (
laya-typed-decisions): Atinge 76,6% de acurácia global (superando o teto de concordância dos professores de 73,5%), com 99,3% em detecção de spam e 98% em detecção de phishing. - Limite de cardinalidade: O Laya trabalha melhor com até 15 a 20 opções por pergunta de
choice. Para taxonomias maiores (ex.: 50+ categorias), a recomendação arquitetural é dividir a decisão em uma árvore hierárquica em dois níveis (ex.: Macro-Área $\rightarrow$ Subcategoria).
3. O Padrão Arquitetural Híbrido no Salesforce
Em ambientes corporativos Salesforce, operações síncronas em Triggers, Email-to-Case ou Omnichannel possuem limites rígidos de tempo de execução (CPU timeout de 10.000ms para transações síncronas e SLAs estritos de experiência do usuário).
Chamar um LLM completo para cada caso recebido é caro, lento e adiciona pontos de falha. A arquitetura recomendada posiciona o Laya como o Filtro de Decisão em Tempo Real, delegando ao Agentforce / Einstein apenas os casos que demandam geração de texto ou raciocínio complexo.
Incoming Email / Case
         │
         ▼
[ Salesforce Apex Trigger / Invocable Action ]
         │
         │ Callout síncrono (~40ms ida e volta na mesma região)
         ▼
 ┌──────────────────────────────────────────────┐
 │ Microserviço Laya (FastAPI / Docker)         │
 │ - Roteia departamento (choice)               │
 │ - Calcula Urgência (score)                   │
 │ - Calcula Risco de Churn (noul, P(true))     │
 └──────────────────────┬───────────────────────┘
                        │
                        ▼ Retorno estruturado tipado
 [ Avaliação das Probabilidades Calibradas em Apex ]
         │
         ├─► Se Churn_Risk > 0.85 & Confiança >= 0.80:
         │     └─► Notifica Account Executive imediatamente + Prioridade "Crítica"
         │
         ├─► Se Decisão Categórica Confiança < 0.70 (Incerteza):
         │     └─► Envia para Fila Humana de Triagem ou invoca Agentforce Reasoning (System 2)
         │
         └─► Se Decisão Confiança >= 0.80:
               └─► Atualiza Fila, Categoria e Executa Auto-Assignment Rule
Code language: PHP (php)
4. Exemplo Prático de Implementação
Passo 1: O Microserviço Laya (Python + FastAPI)
Criamos uma API REST enxuta que mantém o roteador do Laya pré-carregado na memória GPU/CPU para evitar custos de recarregamento.
# main.py
from fastapi import FastAPI, HTTPException
from pydantic import BaseModel
import laya
from laya import Router

app = FastAPI(title="Laya Decision Engine Service")

# Inicializa e pré-carrega os checkpoints em memória
router = Router(preload=True)

class CaseClassificationRequest(BaseModel):
    subject: str
    description: str
    customer_tier: str = "Standard"

@app.post("/v1/triage-case")
def triage_case(payload: CaseClassificationRequest):
    try:
        # 1. Monta o estado da requisição
        state = {
            "subject": payload.subject,
            "body": payload.description,
            "tier": payload.customer_tier
        }

        # 2. Define as perguntas tipadas em tempo de execução
        questions = {
            "queue_routing": {
                "type": "choice",
                "instructions": "Qual departamento deve atender este caso de suporte?",
                "criteria": {
                    "Billing_Queue": "Cobrança duplicada, faturas, notas fiscais, reembolso",
                    "Tier_2_Technical": "Falha de sistema, bug, lentidão, erro de integração, API",
                    "Security_Escalation": "Violação de dados, suspeita de vazamento, credenciais expostas",
                    "General_Support": "Dúvidas de configuração simples, alterações cadastrais"
                }
            },
            "urgency_level": {
                "type": "score",
                "instructions": "Qual a severidade e impacto do problema no negócio do cliente?",
                "criteria": [
                    "Baixo impacto / Operação normal",
                    "Impacto moderado / Contorno disponível",
                    "Impacto crítico / Operação paralisada"
                ]
            },
            "churn_threat": {
                "type": "noul",
                "instructions": "O cliente menciona cancelamento de contrato, processo judicial ou mudança de fornecedor?"
            }
        }

        # 3. Execução em uma única passagem direta (<35ms na GPU)
        prediction = router.predict(state, questions)
        answers = prediction["answers"]
        routing_info = prediction.get("routing", {})

        return {
            "recommendedQueue": answers["queue_routing"]["choice"],
            "queueConfidence": answers["queue_routing"]["confidence"],
            "urgencyScore": answers["urgency_level"]["score"],
            "churnProbability": answers["churn_threat"]["noul"],
            "inferenceLanguage": routing_info.get("model", "auto")
        }

    except Exception as e:
        raise HTTPException(status_code=500, detail=str(e))
Passo 2: O Cliente de Chamada Apex (LayaDecisionService.cls)
No Salesforce, configuramos uma External Credential / Named Credential (callout:Laya_Decision_API) apontando para o endpoint acima. O serviço Apex consome a resposta de forma tipada e segura:
public with sharing class LayaDecisionService {

    public class TriageRequest {
        public String subject;
        public String description;
        public String customerTier;
    }

    public class TriageResult {
        public String recommendedQueue;
        public Decimal queueConfidence;
        public Decimal urgencyScore;
        public Decimal churnProbability;
        public String inferenceLanguage;
    }

    public static TriageResult evaluateCase(String subject, String description, String tier) {
        TriageRequest reqBody = new TriageRequest();
        reqBody.subject = subject;
        reqBody.description = description;
        reqBody.customerTier = tier;

        HttpRequest req = new HttpRequest();
        req.setEndpoint('callout:Laya_Decision_API/v1/triage-case');
        req.setMethod('POST');
        req.setHeader('Content-Type', 'application/json');
        req.setTimeout(3000); // Resposta esperada em sub-100ms
        req.setBody(JSON.serialize(reqBody));

        Http http = new Http();
        HttpResponse res = http.send(req);

        if (res.getStatusCode() == 200) {
            return (TriageResult) JSON.deserialize(res.getBody(), TriageResult.class);
        } else {
            throw new CalloutException('Falha no Laya Decision Engine: ' + res.getStatus() + ' - ' + res.getBody());
        }
    }
}
Passo 3: Automação Inteligente via Invocable Action para Flow ou Apex Trigger
Disponibilizamos a capacidade como uma Invocable Method, permitindo seu uso direto no Salesforce Flow (após o recebimento de um e-mail ou criação de um caso) ou dentro de um processamento de fila assíncrono (Queueable Apex):
public with sharing class LayaTriageAction {

    public class RequestInput {
        @InvocableVariable(required=true label='Case ID')
        public Id caseId;

        @InvocableVariable(required=true label='Subject')
        public String subject;

        @InvocableVariable(required=true label='Description')
        public String description;

        @InvocableVariable(label='Customer Tier')
        public String customerTier;
    }

    public class ResponseOutput {
        @InvocableVariable(label='Target Queue API Name')
        public String targetQueue;

        @InvocableVariable(label='Requires Human Review')
        public Boolean requiresHumanReview;

        @InvocableVariable(label='Is High Churn Risk')
        public Boolean isHighChurnRisk;
    }

    @InvocableMethod(label='Triar Caso com Laya AI' description='Executa classificação de 33ms com probabilidades calibradas')
    public static List<ResponseOutput> executeTriage(List<RequestInput> inputs) {
        List<ResponseOutput> outputs = new List<ResponseOutput>();
        List<Case> casesToUpdate = new List<Case>();

        for (RequestInput input : inputs) {
            ResponseOutput out = new ResponseOutput();

            try {
                LayaDecisionService.TriageResult result = LayaDecisionService.evaluateCase(
                    input.subject,
                    input.description,
                    input.customerTier
                );

                // Gating de Confiança: se a probabilidade for menor que 75%, marcamos para triagem assistida
                if (result.queueConfidence < 0.75) {
                    out.requiresHumanReview = true;
                    out.targetQueue = 'Manual_Triage_Queue';
                } else {
                    out.requiresHumanReview = false;
                    out.targetQueue = result.recommendedQueue;
                }

                // Risco de Churn: avaliado pela probabilidade matemática do teste booleano (noul)
                out.isHighChurnRisk = (result.churnProbability >= 0.80);

                // Mapeia severidade calculada pelo ordinal score
                String calculatedPriority = 'Medium';
                if (result.urgencyScore >= 1.5 || out.isHighChurnRisk) {
                    calculatedPriority = 'High';
                } else if (result.urgencyScore < 0.6) {
                    calculatedPriority = 'Low';
                }

                casesToUpdate.add(new Case(
                    Id = input.caseId,
                    Priority = calculatedPriority,
                    System1_Confidence__c = result.queueConfidence,
                    Churn_Risk_Probability__c = result.churnProbability,
                    System1_Processed__c = true
                ));

            } catch (Exception ex) {
                System.debug(LoggingLevel.ERROR, 'Erro ao avaliar caso no Laya: ' + ex.getMessage());
                out.requiresHumanReview = true;
                out.targetQueue = 'Default_Support_Queue';
            }

            outputs.add(out);
        }

        if (!casesToUpdate.isEmpty()) {
            Database.update(casesToUpdate, false);
        }

        return outputs;
    }
}
5. Matriz Comparativa: Laya vs. LLMs Tradicionais no Salesforce
| Dimensão | LLM Tradicional Autorregressivo (GPT-4o / Claude / Einstein LLM) | Laya System 1 Decision Engine |
|---|---|---|
| Latência Típica | 1.000 ms – 3.500 ms | 32 ms – 40 ms (GPU) / ~200 ms (CPU) |
| Formato de Saída | Tokens de texto sequenciais (necessita parser JSON) | Estruturas tipadas nativas (choice, score, noul) |
| Risco de Alucinação | Presente (pode inventar saídas ou corromper esquemas) | Zero no espaço de opções (opera por marcadores fechados) |
| Calibração de Confiança | Heurística / Não calibrada (números arbitrários) | Matematicamente calibrada via RLCD ($ECE = 0.081$) |
| Custo de Inferência | $0,005 a $0,03 por chamada / créditos Einstein | $0,00 em pesos abertos (Apache 2.0, self-hosted) |
| Papel Arquitetural | System 2: Resumo de histórico, redação de respostas | System 1: Roteamento, triagem, políticas e guardrails |
Conclusão e Recomendações de Adoção
O Laya demonstra que nem todo problema de IA corporativa exige um chatbot autorregressivo. Em tarefas de triagem, conformidade, guardrails e roteamento de dados síncronos no Salesforce, utilizar um modelo de 33ms focado exclusivamente em decisão elimina a latência e o risco de quebras de contrato de dados.
Para equipes de arquitetura que desejam explorar o modelo:
- Comece pelo benchmark: Experimente o espaço interativo no Hugging Face Space do Laya para validar a resposta das primitivas com seus textos de suporte reais.
- Utilize o Router: Mantenha a chamada via classe
Router(preload=True)para que casos em português ou outros idiomas sejam despachados automaticamente para o checkpoint multilíngue (mmBERT-base). - Reserve o Agentforce para o System 2: Deixe o Laya fazer o trabalho mecânico e veloz de filtragem e triagem; quando o cliente precisar de resolução interativa e pesquisa de base de conhecimento, passe o bastão para os agentes generativos do Salesforce.